GAIR实验室
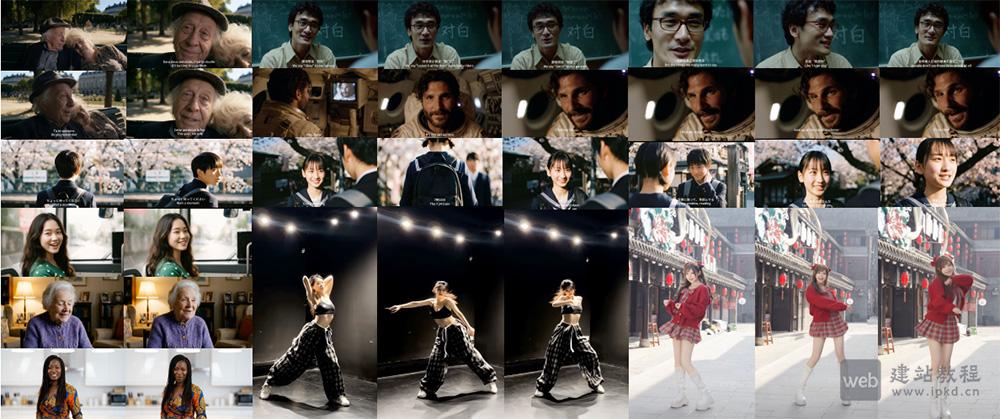
- daVinci-MagiHuman音视频生成模型 - 模型采用150亿参数的单流Transformer架构
daVinci-MagiHuman是由上海创智学院GAIR实验室与Sand.ai联合开源的多模态统一生成模型。模型采用15B参数单流Transformer架构,统一建模文本、视频、音频三大模态,无需跨注意力机制。
daVinci-MagiHuman是由上海创智学院GAIR实验室与Sand.ai联合开源的多模态统一生成模型。模型采用15B参数单流Transformer架构,统一建模文本、视频、音频三大模态,无需跨注意力机制。